
Ten wpis jest podsumowaniem prezentacji podstaw obsługi Gita, którą miałem przyjemność poprowadzić ostatnio dla grupy osób zainteresowanych wsparciem projektu CompTIA Security+ po polsku.
Artykuł skupia się przede wszystkim na możliwościach Gita z perspektywy początkującego współtwórcy dowolnego projektu open source znajdującego się na GitHub (choć większość zaprezentowanego poniżej materiału można z powodzeniem zastosować na innych platformach). Opracowanie ma charakter krótkiego repetytorium, więc zamiast obszernych opisów, zawiera podstawowe informacje ułatwiające codzienną pracę z Gitem oraz zakłada, że środowiskiem pracy jest system Linux.
Version Control System (VCS)
Kontrola wersji (version control) jest jednym z zagadnień, które pojawiają się na egzaminie CompTIA Security+ SY0-701.
Systemy kontroli wersji (VCS) umożliwiają rejestrowanie historii zmian wprowadzanych w kolejnych wersjach oprogramowania, dokumentu, konfiguracji czy innego zasobu cyfrowego. Ich istotną zaletą jest możliwość szybkiego powrotu do określonej wersji, jeśli zachodzi taka potrzeba. Dodatkowo, takie systemy znacząco ułatwiają zespołową współpracę nad jednym projektem.
Systemy lokalne
W lokalnych systemach kontroli wersji (local version control systems) baza danych zawierająca historię zmian, znajduje się w na komputerze użytkownika i jest dostępna tylko lokalnie.
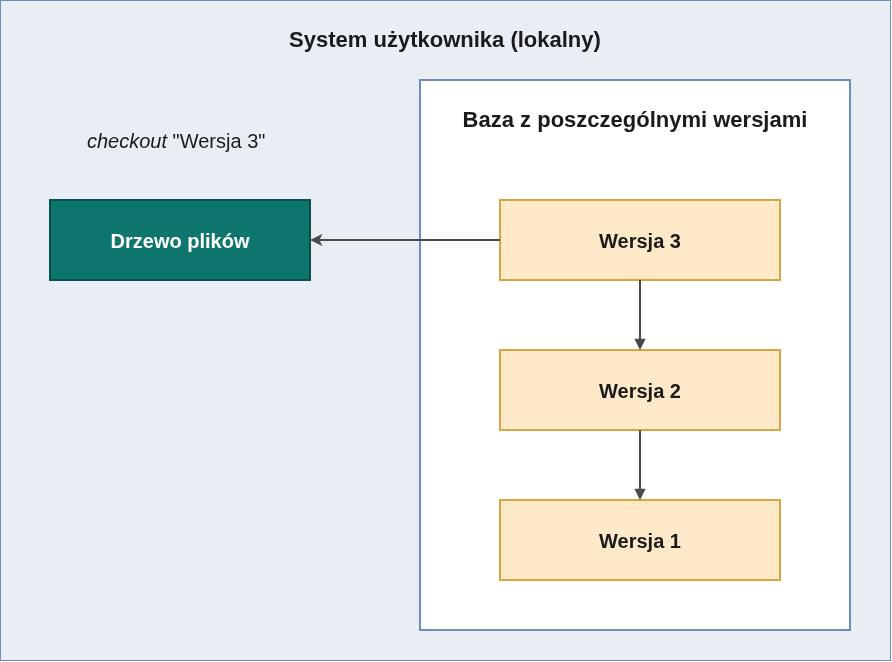
Przykład: GNU RCS.
Systemy scentralizowane
Scentralizowane systemy kontroli wersji (centralized version control systems) są oparte na modelu klient – serwer, dzięki czemu umożliwiają współpracę w zespołach rozproszonych. W tym przypadku pełna historia zmian jest przechowywana na centralnym serwerze, do którego dostęp mają wszyscy uczestnicy projektu.
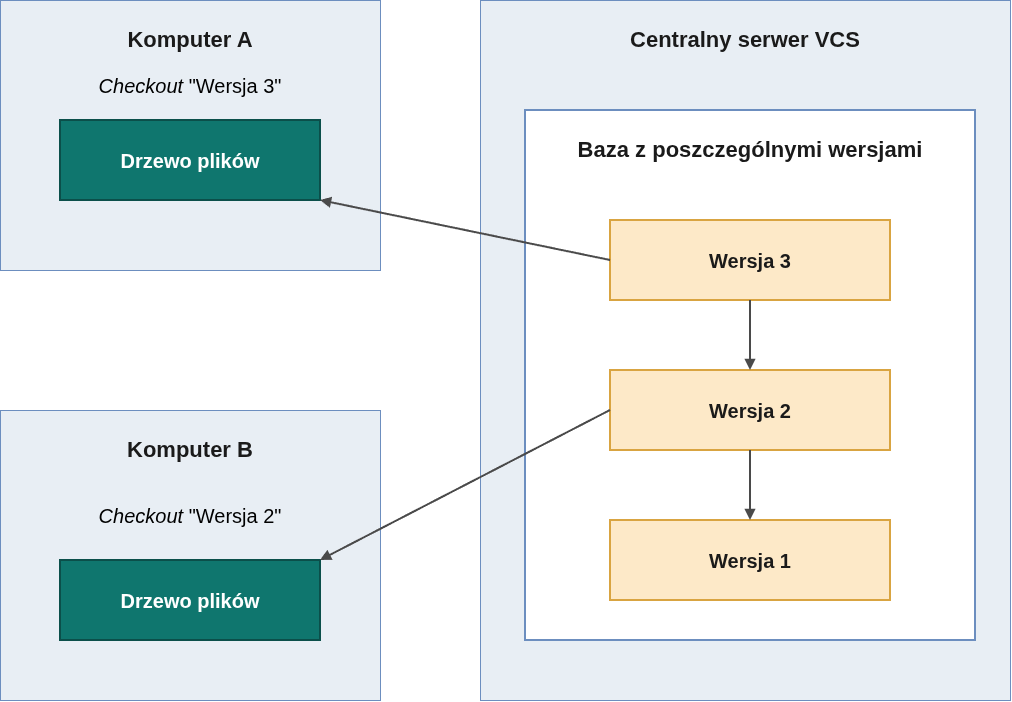
Istotną wadą takiego modelu jest całkowita zależność od działania serwera centralnego, który staje się w tym przypadku SPOF (Single Point of Failure). W przypadku niedostępności serwera z powodu awarii, przeciążenia lub innych przyczyn, zespół nie jest w stanie zapisać zmian do nowej wersji.
Poza tym, w przypadku poważnej awarii nośnika danych na serwerze tracimy całą historię zmian, jeśli nie zadbaliśmy wcześniej o regularne tworzenie kopii zapasowych (backups).
Przykłady:
Systemy rozproszone
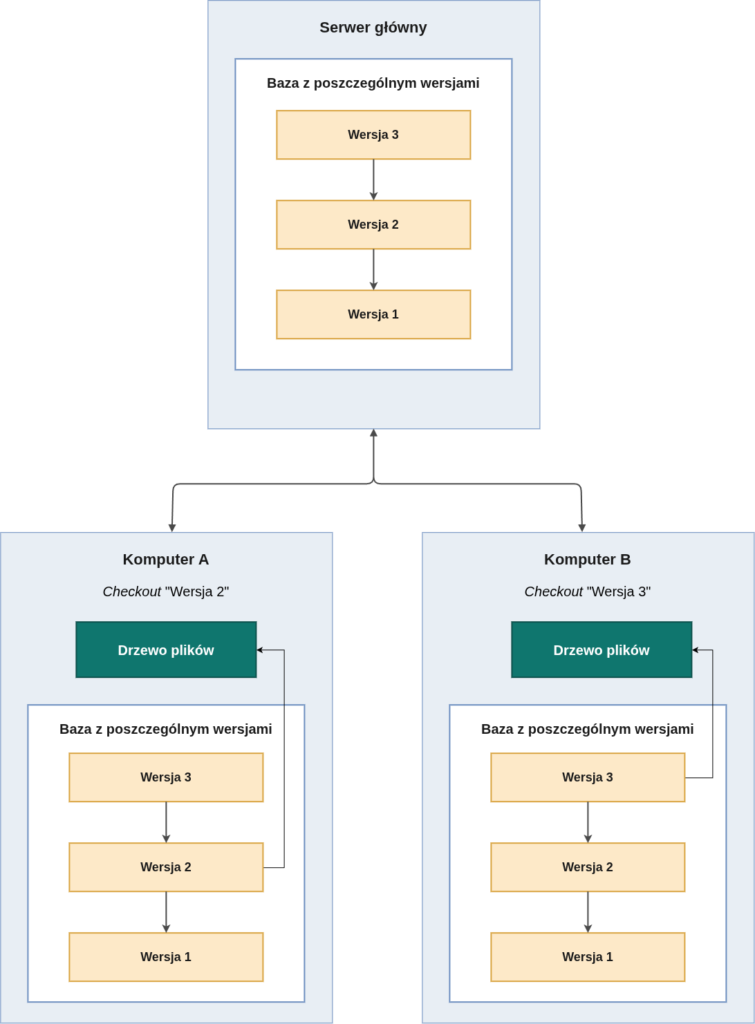
W rozproszonych systemach kontroli wersji (distributed version control systems) kontrybutorzy posiadają na swoich komputerach pełną kopię repozytorium, wraz z historią zmian. Często istnieje również zdalny serwer z repozytorium, który jest głównym punktem synchronizacji. Każdy lokalny klon repozytorium może pełnić rolę kopii zapasowej.
W odróżnieniu od scentralizowanych systemów uczestnicy projektu mogą dalej pracować nad swoimi zmianami, nawet jeśli serwer główny jest tymczasowo niedostępny. Wtedy synchronizacja następuje dopiero po przywróceniu łączności.
Przykłady:
Git w skrócie
Git to rozproszony system kontroli wersji, używany do śledzenia zmian w plikach, przede wszystkim w kodzie źródłowym. Pozwala wielu osobom pracować nad tym samym projektem jednocześnie, bez nadpisywania sobie pracy. Jest to prawdopodobnie jeden z najpopularniejszych systemów VCS, charakteryzujący się ogromnym ekosystemem narzędzi (GitHub, GitLab, Codeberg). Jego głównymi zaletami są szybkość działania, możliwość pracy offline oraz wygodna praca z gałęziami (branching).
Pierwsza wersja Gita została napisana przez Linusa Torvaldsa w 2005 roku w bardzo krótkim czasie (rzędu kilku tygodni). Była to błyskawiczna odpowiedź na potrzebę posiadania odpowiedniego narzędzia do zarządzania rozbudowanym kodem źródłowym jądra Linux, zaraz po tym jak firma BitMover wycofała darmową licencję używanego dotychczas programu BitKeeper. Szczegóły tej sytuacji: The kernel and BitKeeper part ways.
Transfer danych
Ponieważ Git jest systemem rozproszonym, do jego działania niezbędny jest protokół, który umożliwi dwustronną komunikację pomiędzy repozytorium zdalnym (hostowanym na serwerze) a lokalnym.
Do wyboru są następujące protokoły:
- Local – istnieje możliwość trzymania zdalnego repozytorium na lokalnym komputerze (np. w katalogu
/srv/git/project.git). Połączenie sieciowe jest wtedy zbędne, jednakże trudno jest w tym przypadku pracować nad projektem w rozproszonym zespole. - Protokół Git (
git://) – natywny i szybki protokół do odczytu danych z repozytorium. Wykorzystuje port sieciowy 9418. Dziś jest raczej rzadko używany ze względu na brak szyfrowania oraz uwierzytelnienia, a także ze względu na komunikację read-only. - HTTPS – pozwala na transfer danych przez protokół HTTP z szyfrowaniem TLS, zwykle z użyciem loginu i specjalnego tokena uwierzytelniającego.
- SSH – umożliwia bezpieczne, szyfrowane połączenie zdalne z repozytorium zdalnym. Komunikacja opiera się na kluczach asymetrycznych. Ten sposób komunikacji jest często wykorzystywany przy pracy z repozytoriami GitHub.
Współpraca na GitHub
Zdaje się, że najpopularniejszą platformą umożliwiającą współpracę nad projektami OSS (Open Source Software) jest ciągle GitHub, więc skupimy się głównie na niej.
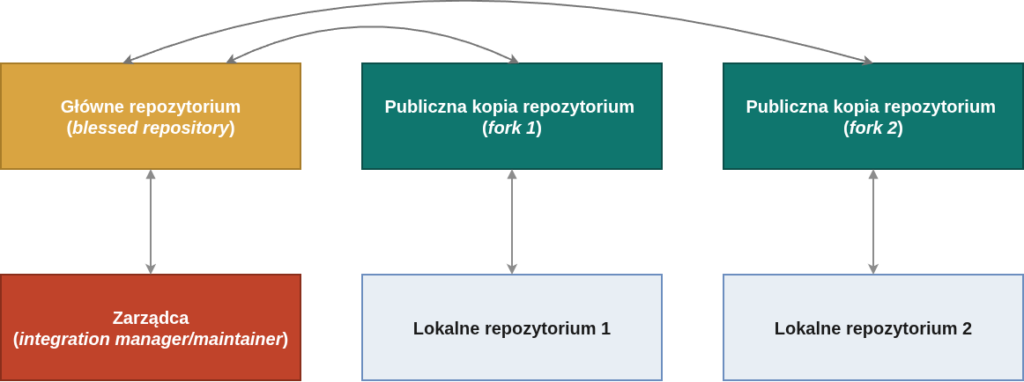
W przypadku publicznych projektów OSS dominuje tryb pracy, który można nazwać Integration-Manager Workflow:
- Główny Zarządca (project maintainer/integration manager) umieszcza projekt w głównym, nadrzędnym repozytorium (tzw. blessed repository).
- Kontrybutor (contributor) kopiuje to repozytorium do siebie (fork na GitHub) i pracuje przede wszystkim na swojej kopii publicznej.
- Następnie Kontrybutor zgłasza Zarządcy, że ma zmiany do głównego repozytorium.
- Zarządca pobiera zmiany od Kontrybutora i dodaje je do głównego repozytorium.
1. Przygotowanie konta GitHub (GH) i zdalnego repozytorium
Założenie konta na GitHub jest bardzo proste, więc przyjmijmy, że mamy już nowe konto, na którym nie wykonywaliśmy jeszcze żadnych działań.
Ponieważ do komunikacji wykorzystamy protokół SSH, w pierwszej kolejności należy dodać do naszego konta klucz publiczny. Ta czynność jest dobrze opisana w oficjalnej dokumentacji: Connecting to GitHub with SSH, więc tutaj tylko w skrócie:
- Generujemy nową parę kluczy (jeśli jeszcze ich nie posiadamy) dla naszego użytkownika:
ssh-keygen -t ed25519 -C "user@example.com". - Kopiujemy całą zawartość pliku
~/.ssh/id_ed25519.pub(zakładając, że użyliśmy domyślnej ścieżki podczas generowania kluczy) z kluczem publicznym. Klucz prywatny powinien znajdować się w plikuid_ed25519i nigdy się nim nie dzielimy! - Klucz publiczny umieszczamy w stosownych ustawieniach profilu GitHub, w sekcji SSH keys (przycisk New SSH key).
Teraz powinniśmy utworzyć fork repozytorium, nad którym chcemy pracować, na naszym koncie. Wchodzimy na stronę interesującego nas repozytorium i klikamy przycisk Fork, znajdujący się w prawym górnym rogu:
Po tej operacji powinniśmy mieć na swoim profilu GH kopię interesującego nas repozytorium i to na niej będziemy pracować bezpośrednio.
2. Przygotowanie lokalnego repozytorium
Na tym etapie powinniśmy już mieć przygotowane zdalne repozytorium na GitHub, więc nadszedł czas na utworzenie repozytorium lokalnego. W pierwszej kolejności instalujemy klienta Git. Tutaj skupiamy się przede wszystkim na interfejsie tekstowym, ale Git oferuje szeroki zakres nakładek graficznych: GUI Clients.
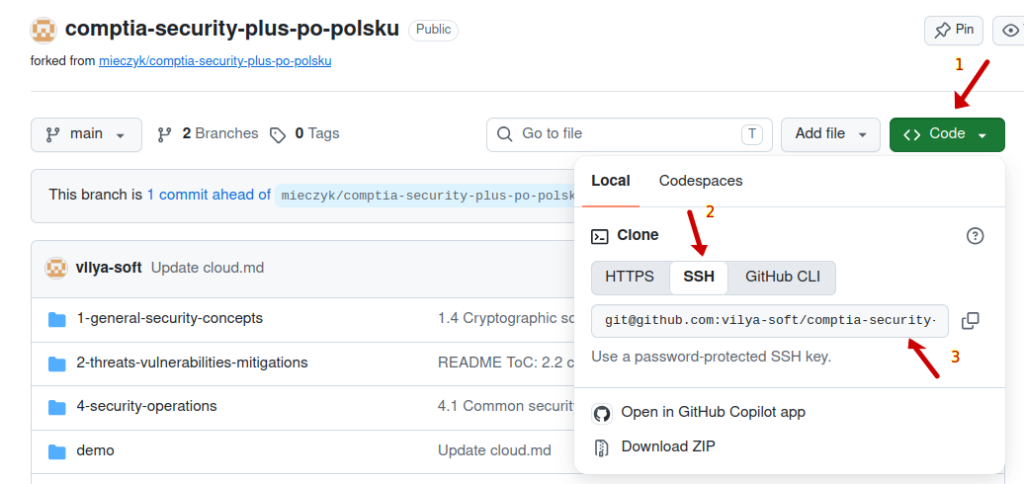
Pobieramy repozytorium za pomocą polecenia git clone <URI>. Adres URI repozytorium bierzemy z GitHub:
Po zakończeniu pobierania danych, na naszym dysku pojawi się katalog z zawartością repozytorium. Ponieważ użyliśmy polecenia git clone bez żadnych opcji, nazwa katalogu będzie identyczna jak nazwa repozytorium.
Po wejściu do katalogu z ściągniętym projektem możemy wykonać polecenie git remote -v, które pokaże nam listę zdalnych repozytoriów, powiązanych z naszym lokalnym repozytorium. Przykładowy wynik:
origin    git@github.com:vilya-soft/comptia-security-plus-po-polsku.git (fetch)
origin git@github.com:vilya-soft/comptia-security-plus-po-polsku.git (push)W tym przypadku mamy jeden adres używany zarówno do pobierania danych (fetch), jak do ich wysyłania (push). origin to skrótowa nazwa domyślna zdalnego repozytorium, którą można zmienić jeśli zechcemy.
Żeby ułatwić sobie pracę w terminalu (powłoka Bash), możemy dodać następujące instrukcje do pliku konfiguracyjnego ~/.bashrc:
# Set Git language to English.
alias git='LANG=en_US git'

# Show current Git branch in the shell prompt.
parse_git_branch() {
 	git branch 2> /dev/null | sed -e '/^[^*]/d' -e 's/* \(.*\)/(\1)/'
}

export PS1="\u@\h \[\e[32m\]\w \[\e[91m\]\$(parse_git_branch)\[\e[00m\]$ "

# Locale setting (Unicode).
export LC_ALL=C.UTF-8Oczywiście po edycji pliku należy wykonać polecenie source ~/.bashrc lub ponownie uruchomić terminal.
W katalogu z projektem można zauważyć jeszcze podkatalog .git, który jest lokalną bazą obiektów i metadanych całego repozytorium Git. Historia projektu jest przechowywana w postaci migawek (ang. snapshots) całego drzewa plików.
W uproszczeniu, pojedynczy commit to obiekt, który wskazuje na konkretny snapshot drzewa plików określonej wersji projektu. Strukturę commita można przedstawić następująco:
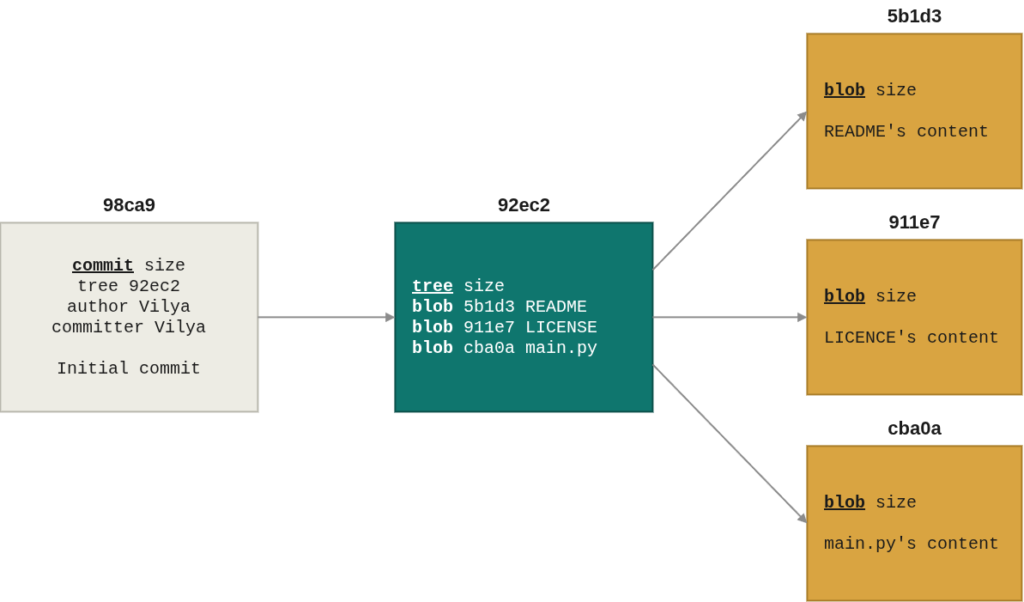
Źródło: opracowanie własne (przy wsparciu GenAI).
Jak widać na powyższym schemacie, tworzenie commita polega na tym, że Git dla każdego pliku tworzy obiekt typu blob, zawierający jego treść. Następnie dla każdego katalogu i podkatalogu budowany jest obiekt typu tree, który zawiera listę wpisów wraz z referencjami do odpowiadających im obiektów blob (pliki) lub innych tree (podkatalogi). W ten sposób powstaje struktura drzewiasta, której korzeniem jest obiekt tree wskazujący na główny katalog projektu. Na końcu tworzony jest obiekt commit, który zawiera metadane oraz wskaźnik do nadrzędnego obiektu tree, reprezentującego stan całego projektu w danym momencie.
Lista commitów (historia zmian) to nic innego jak jednokierunkowa lista (intuicyjnie, bo technicznie jest to skierowany graf acykliczny) , w której każdy kolejny commit (oprócz pierwszego) zawiera referencję do swojego bezpośredniego poprzednika (rodzica):
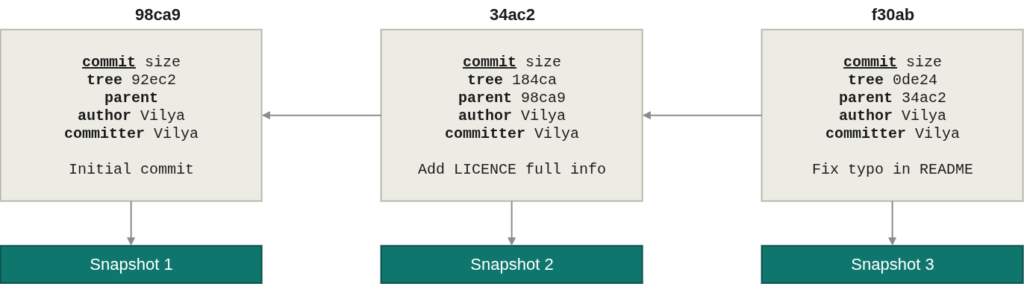
Podstawowe polecenie pozwalające na przegląd historii commitów:
git log– lista commitów na bieżącej gałęzi. Dla każdego commita otrzymujemy informację o identyfikatorze SHA1, autorze, dacie, tytule oraz opisie.git log --all– lista commitów na wszystkich gałęziach.git log -p– wyświetla treść zmian, które zostały wprowadzone w ramach poszczególnych commitów.git log --name-only– wyświetla nazwy plików, które zostały dodane, zmienione lub usunięte w ramach konkretnego commita.git log --name-status– oprócz nazw plików wyświetla informację, co dokładnie zostało zmienione w określonym pliku- M = modified.
- A = added.
- D = deleted.
git log --graph– lista commitów w postaci grafu.
Przykład:
git log --name-statusWynik:
commit 7c5c5c9549d7a016f3d8ae8cd61f9c8b9d151c24 (HEAD -> main)
Author: Vilya Soft <vilya@example.com>
Date:   Thu Sep 17 20:39:48 2026 +0200

    New version

M       demo/cloud.md
D       demo/trash.md

commit 4a1bca86eb6c3f63ae4a9fe393c4920d87b080c6 (origin/main, origin/HEAD)
Author: vilya-soft <vilya@example.com>
Date:   Mon Sep 14 19:31:06 2026 +0200

    Update Cloud description

M       demo/cloud.md

commit 3d295acb49a1facbe3d46c09cd8ad4741ac935aa
Author: vilya-soft <vilya@example.com>
Date:   Mon Sep 14 19:25:53 2026 +0200

    Create Cloud description

A demo/cloud.mdŻeby przełączyć się na konkretną wersję używamy polecenia git checkout <commit_id>. Po jego wywołaniu Git odtwarza odpowiedni snapshot z lokalnej bazy obiektów Git i aktualizuje drzewo robocze (ang. working tree), czyli aktualny stan plików na dysku.
Git pozwala również na wyszukiwanie określonej frazy w aktualnym drzewie roboczym (working tree):
git grep <phrase>– wyświetla linie w plikach repozytorium, w których pojawia się określona fraza (case sensitive).git grep -i <phrase>– wyświetla linie w plikach repozytorium, w których pojawia się określona fraza (case insensitive).git grep -n <phrase>– oprócz dopasowanych linii wyświetla również numer linii.git grep -e <phrase1> --and -e <phrase2>– znajduje linie zawierające obie frazy.- Opcja
--andłączy warunki wyszukiwania logicznym AND. - Opcja
-epozwala podać kilka wzorców wyszukiwania, które mogą być łączone operatorami logicznymi (np.--and).
- Opcja
Przykład:
git grep -n CIAWynik:
1-general-security-concepts/1-2-fundamental-security-concepts.md:3:# Confidentiality, Integrity, and Availability (CIA)
1-general-security-concepts/1-2-fundamental-security-concepts.md:4:**Triada CIA**, często przedstawiana graficznie w formie trójkąta, opisuje **fundamentalne cele bezpieczeństwa IT**. Są to:
1-general-security-concepts/1-2-fundamental-security-concepts.md:9:Zbieżność z akronimem amerykańskiej Centralnej Agencji Wywiadowczej (CIA = *Central Intelligence Agency*) jest przypadkowa, ale to skojarzenie pomaga zachować skrót na dłużej w pamięci.
1-general-security-concepts/1-2-fundamental-security-concepts.md:11:Czasami można się jeszcze spotkać z terminem **triady DAD** (*Disclosure, Alteration, Denial*), która przedstawia **trzy główne zagrożenia dla bezpieczeństwa IT** i stanowi zupełne przeciwieństwo triady CIA:3. Podstawowa konfiguracja
Konfigurację Git można zdefiniować na 3 poziomach:
- Systemowym (plik
/etc/gitconfig) – zawiera ustawienia dla wszystkich użytkowników systemu.git config --list --system– wyświetla konfigurację systemową.
- Globalnym (plik
~/.gitconfig) – zawiera ustawienia dla wszystkich repozytoriów danego użytkownika.git config --list --global– wyświetla konfigurację aktualnie zalogowanego użytkownika.
- Lokalnym (plik
.git/config) – zawiera ustawienia dla konkretnego repozytorium.git config --list --local– wyświetla konfigurację lokalnego repozytorium.
Jeśli to samo ustawienie pojawia się na różnych poziomach, to finalna wartość zawsze brana jest z poziomu lokalnego. Najwyższy priorytet ma konfiguracja repozytorium, potem globalna, a na końcu systemowa. Jeśli interesuje nas gdzie dokładnie zostało zdefiniowane określone ustawienie, można użyć polecenia git config --list --show-origin.
Przykład ustawienia danych autora i domyślnego edytora tekstowego na poziomie użytkownika:
git config --global user.name "Vilya"
git config --global user.email "vilya@example.com"
git config --global core.editor vimKiedy chcemy podejrzeć wartości konkretnych ustawień:
$ git config --global user.name
Vilya

$ git config --global user.email
vilya@example.com

$ git config --global core.editor
vim4. Wprowadzanie zmian
Gałęzie (branches)
Przy podejściu branch per feature/topic każda nowa funkcjonalność lub temat są realizowane w ramach osobnej gałęzi. Kiedy praca jest zakończona, wszystkie zmiany trafiają ostatecznie do gałęzi głównej.
W celu utworzenia nowej gałęzi i jej aktywacji, wydajemy 2 polecenia:
git branch <topic_branch_name>
git switch <topic_branch_name>lub krócej:
git checkout -b <topic_branch_name>Co oznacza, że do przełączania się między gałęziami można wykorzystać również polecenie git checkout, które służy m.in. do przełączania się między commitami i gałęziami. Jest to spowodowane tym, że nazwa gałęzi (<topic_branch_name>) to nic innego jak ruchomy wskaźnik na konkretny commit.
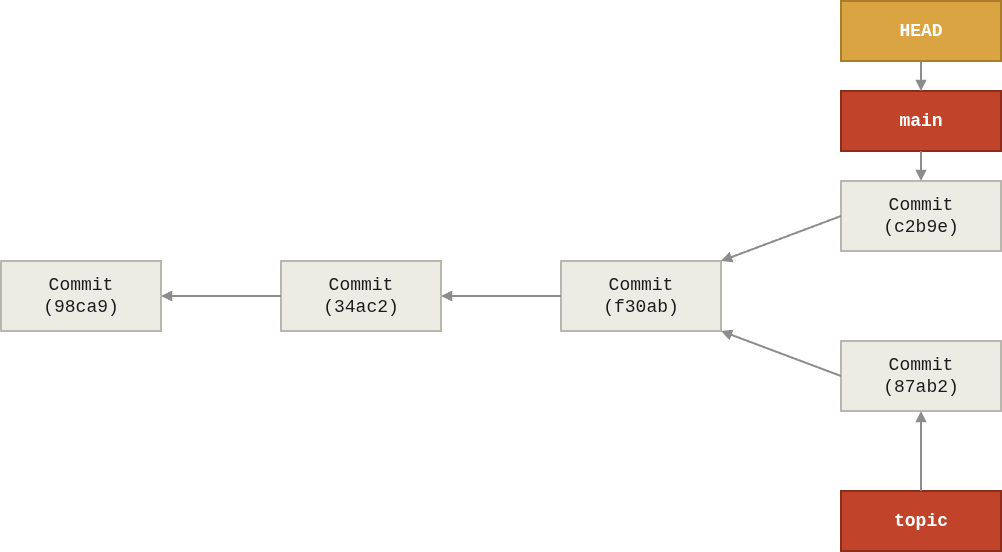
Na powyższym schemacie widać rozgałęzienie: branch o nazwie topic został utworzony z poziomu commita f30ab. Następnie powstały 2 commity: jeden tylko na gałęzi main (c2b9e), a drugi na gałęzi topic (87ab2).
Widoczna na diagramie referencja HEAD to wskaźnik symboliczny na aktualną gałąź (ang. current branch), a pośrednio na commit określający bieżący stan repozytorium. W tym konkretnym przykładzie zarówno HEAD, jak i main wskazują na ten sam commit, co oznacza, że polecenia git checkout HEAD oraz git checkout main są równoważne. Zdarza się, że HEAD wskazuje bezpośrednio na commit – wtedy Git informuje nas o trybie detached HEAD.
W celu wyświetlenia listy gałęzi, używamy polecenia:
git branch– tylko gałęzie lokalne.git branch -r– tylko gałęzie zdalne (zapisane na serwerze w zdalnym repozytorium).git branch -a– wszystkie gałęzie.
W celu wyświetlenia większej liczby szczegółowych informacji, możemy posłużyć się przełącznikiem -vv:
git branch -vvPrzykładowy rezultat:
* main      7c5c5c9 [origin/main: ahead 1] New version
new_topic 4c3b04e Merge branch 'main' into new_topicZ powyższego wyniku dowiadujemy się, że:
- Lokalna gałąź
mainjest teraz aktywna oraz śledzi (ang. tracks) zdalną gałąźorigin/main(gałąź lokalna ma też jeden commit więcej niż zdalna, więc zmiany lokalne nie zostały jeszcze wypchnięte na serwer). Dodatkowo dowiadujemy się, że ID ostatniego commita tej gałęzi to7c5c5c9, a jego tytuł brzmi: New version. - Drugą lokalną gałęzią jest
new_topic, która nie ma aktualnie żadnej śledzonej gałęzi zdalnej, a jej ostatni commit ma tytuł Merge branch ‘main’ into new_topic oraz ID4c3b04e.
W kwestii wspomnianego powyżej śledzenia:
- Tracking branch – gałąź lokalna, która ma ustawione śledzenie gałęzi zdalnej.
- Upstream branch – gałąź (przeważnie zdalna) śledzona przez gałąź lokalną.
To śledzenie (ang. tracking, upstream) nie jest wymagane do codziennej pracy, ale ułatwia synchronizacje. Bez ustawionych tracking/upstream branches, przy poleceniach typu git push/pull musimy jawnie określać którą gałąź zdalną mamy na myśli, na przykład:
git switch main         # Aktywacja gałęzi 'main'.
git push origin main    # Wypchnięcie lokalnych zmian do zdalnej gałęzi 'main'.
git pull origin main # Pobranie najnowszych zmian z zdalnej gałęzi 'main'.Z włączonym śledzeniem wystarczy:
git switch main         # Aktywacja gałęzi 'main'.
git push                # Wypchnięcie lokalnych zmian do zdalnej gałęzi 'main'.
git pull # Pobranie najnowszych zmian z zdalnej gałęzi 'main'.Branch tracking można włączyć na kilka sposobów:
# Kiedy gałąź zdalna już istnieje i chcemy na jej podstawie utworzyć gałąź lokalną.
git switch -c <branch_name> origin/<branch_name>
# Jak wyżej, ale z użyciem starszej składni:
git checkout -b <branch_name> origin/<branch_name>

# Tworzenie nowej gałęzi z jej wypchnięciem na serwer zdalny z odpowiednią opcją (-u lub --set-upstream).
git switch -c  <branch_name>
git push -u origin <branch_name>

# Włączenie śledzenia dla istniejących gałęzi (lokalnej i zdalnej).
git switch <branch_name>
git branch --set-upstream-to=origin/<branch_name>Praca z plikami
Teraz najważniejsza część całego przedsięwzięcia, czyli wprowadzanie właściwych zmian w projekcie. Powinniśmy już mieć utworzoną nową gałąź, która jest aktywna – nazwijmy ją new_topic dla przykładu:
# Upewnijmy się, że gałąź główna jest up-to-date.
git switch main
git pull

# Utworzenie nowej gałęzi z automatyczną aktywacją.
git switch -c new_topicŻeby zobaczyć aktualny status, wydajemy polecenie git status:
$ git status

On branch new_topic
nothing to commit, working tree cleanWidzimy informację, że drzewo robocze jest czyste, ponieważ nie wprowadziliśmy jeszcze żadnych zmian, więc zróbmy to teraz:
# Nowy plik.
echo "Hello world" > new.txt

# Modyfikacja istniejącego (zakładajac, że plik README.md znajduje się w repozytorium).
echo "New line" >> README.md

# Zmiana rozszerzenia pliku (zakładając, że plik LICENCE.txt znajduje się w repozytorium).
mv LICENSE.txt LICENSE.md

# Usunięcie pliku (zakładając, że plik demo/trash.md znajduje się w repozytorium).
rm demo/trash.mdSprawdźmy status ponownie. Powinniśmy ujrzeć wynik podobny to przedstawionego poniżej:
$ git status

On branch new_topic
Changes not staged for commit:
  (use "git add/rm <file>..." to update what will be committed)
  (use "git restore <file>..." to discard changes in working directory)
	deleted:    LICENSE.txt
	modified:   README.md
	deleted:    demo/trash.md

Untracked files:
  (use "git add <file>..." to include in what will be committed)
	LICENSE.md
	new.txt

no changes added to commit (use "git add" and/or "git commit -a")Rozłóżmy otrzymany komunikat na czynniki pierwsze:
- Changes not staged for commit – sekcja zawierająca pliki już śledzone przez repozytorium, których zmiany nie trafiły jeszcze do tzw. staging area (technicznie jest to plik
.git/index, przechowujący informacje o zmianach, które mają trafić do kolejnego commita). Żeby zobaczyć jakie konkretne zmiany czekają na dodanie do staging area, możemy użyć poleceniagit diff. - Untracked files – sekcja zawierające nowe pliki, które jeszcze nie są częścią repozytorium Git.
- Fakt oznaczenia pliku
LICENSE.txtjako usunięty może wydawać się nieco mylący. Po zmianie rozszerzenia pliku na dysku, Git widzi tylko to, że śledzony plik z rozszerzeniem*.txtzniknął, więc oznaczył go jako usunięty. Pojawił się z kolei nowy plik z rozszerzeniem*.md, który jeszcze nie jest częścią repozytorium. Wynika to z tego, że Git nie pamięta jakie operacje zostały przeprowadzone, a jedynie porównuje stany plików.
Dodanie nowego, nieśledzonego pliku do repozytorium:
# git add <filename>
git add new.txtDodanie zmian w śledzonym pliku:
# Dodawanie zmian stopniowo, kawałek po kawałku (chunks).
git add -p

# Dodanie wszystkich zmian z wybranego pliku.
git add README.mdZmiana nazwy (w tym przypadku rozszerzenia) pliku:
# git mv <old_filename> <new_filename>
git mv LICENSE.txt LICENSE.mdUsunięcie pliku z repozytorium:
# git rm <filename>
git rm demo/trash.mdZmiany zostały już przygotowane do utworzenia nowego obiektu commita, co za chwilę uczynimy. Jeśli nie chcemy dodawać do staging area zmian pojedynczo i jesteśmy ich pewni, możemy użyć polecenia git add -A, które dodaje wszystkie wykryte zmiany oraz nowe pliki za jednym zamachem. Inną ciekawostką jest fakt, że polecenie git add -p uwzględnia zawartość plików usuniętych z repozytorium.
Przed utworzeniem commita, sprawdźmy ponownie status. Widzimy, że wszystkie zmiany trafiły już do staging:
$ git status

On branch new_topic
Changes to be committed:
  (use "git restore --staged <file>..." to unstage)
	renamed:    LICENSE.txt -> LICENSE.md
	modified:   README.md
	deleted:    demo/trash.md
new file: new.txtW tym momencie git diff nic nam już nie pokaże. Jeśli chcemy podejrzeć zmiany znajdujące się w indeksie staging, musimy dodać opcję --cached.
Utworzenie nowego commita jest stosunkowo proste. Wystarczy wydać jedno z poniższych poleceń i Git utworzy nowy obiekt zawierający wszystkie zmiany znajdujące się w staging:
# Po wykonaniu polecenia otworzy się edytor tekstowy, gdzie będziemy mogli wpisać tytuł i opis commita.
git commit

# Commit tworzony jest od razu z tytułem, ale bez opisu.
git commit -m "<title>"

# Commit tworzony jest od razu z tytułem i opisem.
git commit -m "<title>" -m "<description>"Zdarza się, że niektóre pliku znajdują się na dysku lokalnym, ale nie chcemy ich dodawać do repozytorium (np. katalogi konfiguracyjne środowiska pracy, takie jak .vscode). W tym celu wykorzystuje się specjalny plik .gitignore, znajdujący się w repozytorium i zawierający zbiór wzorców, na podstawie których Git wyklucza śledzenie zmian (z wyjątkiem plików już śledzonych przez Git).
Kilka uwag dotyczących zawartości pliku .gitignore:
- Wzorce te są domyślnie dopasowywane rekurencyjnie w całym drzewie katalogów.
- Puste linie i te rozpoczynające się od
#są ignorowane. - Wzorce mogą zawierać znaki zastępcze (wildcards), np.
*,?, czy[]. - Wzorce zaczynające się od
/są dopasowywane względem katalogu, w którym znajduje się plik.gitignore(nie w całym drzewie). - Wzorce zakończone slashem
/wskazują na katalog. - Wykrzyknik
!na początku wzorca oznacza negację.
Cofanie zmian
Może się zdarzyć, że gdzieś po drodze popełnimy błąd i chcemy wycofać wprowadzone zmiany. W zależności od tego czego potrzebujemy, mamy kilka możliwości:
- Kiedy zmodyfikowaliśmy plik, ale chcemy przywrócić oryginalną wersję:
git restore <filename>git checkout <filename>– jest to stary sposób. Dalej działa, ale lepiej użyć komendyrestore.
- Kiedy chcemy permanentnie usunąć wszystkie lokalne zmiany, które jeszcze nie trafiły do commita (spowoduje to usunięcie wszystkich lokalnych zmian z dysku):
git reset --hard
- Kiedy stworzyliśmy commit, ale chcemy go usunąć:
git reset --soft HEAD~– przesunie wskaźnikHEADna poprzedni commit (HEAD~oznacza pierwszego rodzica aktualnej wersji), ale w indeksie (staging area) zostaną pliki z ostatniego commita.git reset --mixed HEAD~– opcja domyślna. Robi to samo co--soft, ale czyści stage area z zmian, które dalej są widoczne w drzewie roboczym jako zmodyfikowane pliki.git reset --hard HEAD~– robi to co dwie poprzednie opcje oraz usuwa wszystkie dane ostatniego commita z working tree. W praktyce umożliwia całkowite pozbycie się commita wskazywanego przezHEAD.- Zamiast specjalnego wskaźnika
HEADmożemy podać tutaj dowolny identyfikator.
- Kiedy utworzyliśmy commit, ale chcemy go jeszcze uzupełnić:
git commit --amend– to polecenie dodajemy już po przygotowaniu zmian w staging. Wtedy otworzy nam się edytor z możliwością zmiany tytułu oraz opisu ostatniego commita. Jeśli chcemy, żeby zmiany trafiły od razu do ostatniego commita, bez zmiany jego opisu, możemy użyć opcji--no-edit.
Podczas pracy nad repozytorium zdarza się, że potrzebujemy podejrzeć sobie pierwotną wersję pliku, ale nie chcemy tracić naszych zmian. W tym przypadku wygodną opcją jest schowek (git stash), posiadający strukturę stosu (Last-In, First-Out):
# Dodanie zmiany spoza staging do schowka.
git stash

# Zobacz elementy odłożone do schowka.
git stash list

# Pobierz zmiany znajdujące się na górze schowka i dodaj je do drzewa roboczego.
git stash apply

# Pobierz zmiany znajdujące się na górze schowka, dodaj je do drzewa roboczego i automatycznie usuń je ze schowka.
git stash pop5. Publikacja i zgłoszenie zmian
Kiedy commity na gałęzi roboczej są gotowe, możemy je wypchnąć do naszego zdalnego repozytorium. Posłużmy się powyższym przykładem z gałęzią new_topic:
# Upewnijmy się, że jesteśmy na odpowiedniej gałęzi.
git switch new_topic

# Wypchnięcie zmian do zdalnego repozytorium (z śledzeniem gałęzi).
git push -u origin new_topicTeraz na platformie GitHub powinniśmy otworzyć Pull Request (PR) z naszymi zmianami, żeby mogły ostatecznie trafić do repozytorium głównego. Należy pamiętać, że PR tworzymy względem repozytorium bazowego, ale kiedy utworzymy gałąź zdalną, GitHub często nam ułatwia sprawę, wyświetlając odpowiednie komunikaty na naszym profilu:
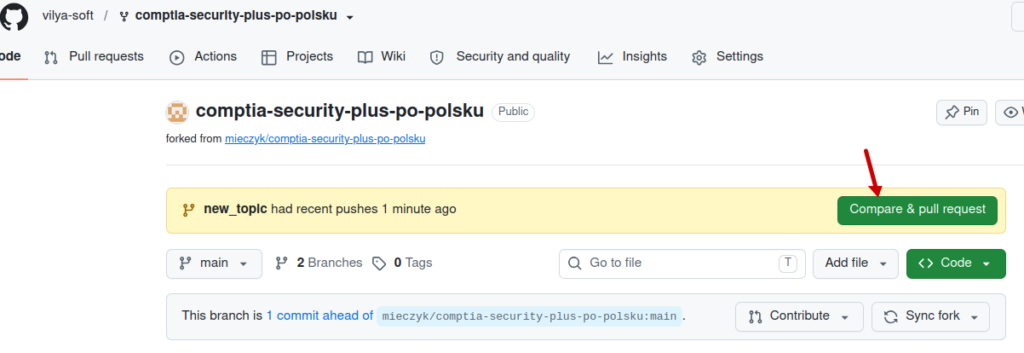
Ekran tworzenia nowego PR powinien wyglądać następująco:
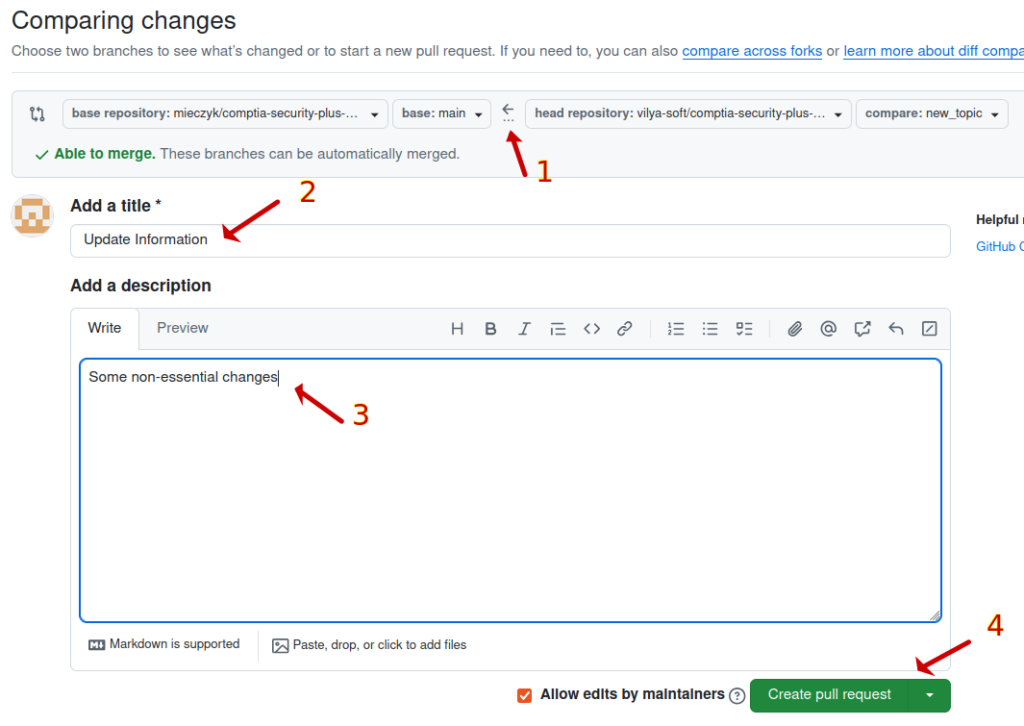
- To ustawienie jest istotne ponieważ jako docelowy kierunek wskazujemy repozytorium bazowe oraz gałąź główną
main, a po prawej stronie topic branch, znajdujący się w naszej kopii repozytorium. Oznacza to, że po akceptacji PR, zmiany z gałęzinew_topictrafią ostatecznie do głównej gałęzimainbazowego repozytorium. - Tutaj umieszczamy tytuł Pull Requesta.
- Opis jest wprawdzie opcjonalny, ale warto zostawić trochę szerszą informację, czego dotyczy dany PR. Jest to często pomocne dla maintainera, który będzie weryfikował zaproponowane zmiany.
- Utworzenie PR.
Od tego momentu piłka jest po stronie zarządcy. W ramach PR może odbywać się dyskusja dotycząca zmian, propozycje ewentualnych poprawek itd. Kiedy zarządca uzna, że zaproponowane zmiany można już wrzucić do repozytorium głównego, robi merge do głównej gałęzi.
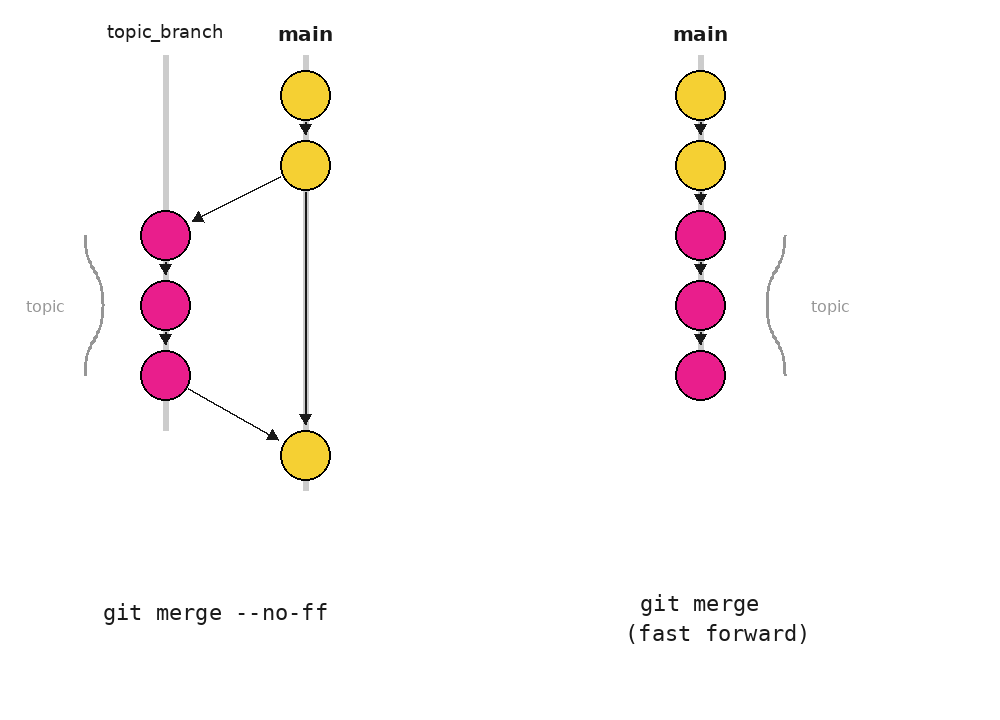
Merge (scalenie) może odbyć się w 3 wariantach (załóżmy, że jesteśmy na gałęzi głównej):
git merge --no-ff <topic_branch>– tworzony jest osobny commit scalający (ang. merge commit), ale zachowana jest cała historia commitów z gałęzi roboczej<topic_branch>.git merge --squash <topic_branch>– wszystkie commity z gałęzi<topic_branch>są ściskane w jeden commit, który jest dodawany na samym szczycie gałęzi głównej (brak commita scalającego).git merge <topic_branch>– jeśli jest to możliwe (tj. ostatni commit z głównej gałęzi jest bezpośrednim przodkiem pierwszego commita gałęzi roboczej), Git przesunie wskaźnik głównej gałęzi do przodu, czyli na ostatni commit gałęzi<topic_branch>(tzw. fast forward). W przeciwnym razie powstanie osobny commit scalający.
6. Aktualizacja repozytorium
Załóżmy, że zgłoszone przez nas zmiany trafiły już do repozytorium głównego. W międzyczasie kilku innych kontrybutorów również zgłosiło swoje propozycje, które zostały zaakceptowane i dodane do gałęzi głównej. Jeśli chcemy pracować dalej nad repozytorium, musimy zaktualizować zarówno nasze repozytorium publiczne, jak i repozytorium lokalne. W przeciwnym razie będziemy pracować na nieaktualnej wersji, co najprawdopodobniej skończy się ogromną liczbą konfliktów do rozwiązania.
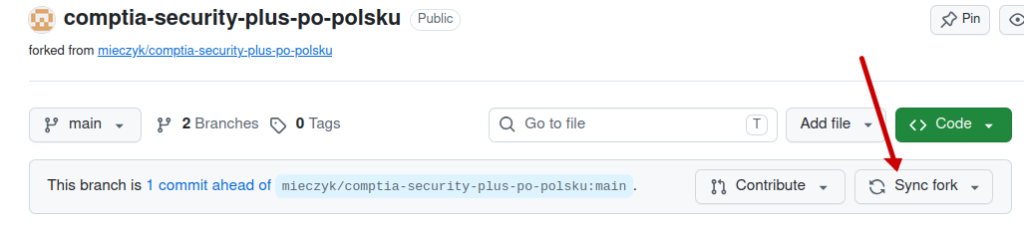
W pierwszej kolejności aktualizujemy nasz fork na GitHubie, synchronizując go z repozytorium głównym:
Teraz aktualizujemy nasze lokalne repozytorium:
# Pobranie informacji o zmianach, ale jeszcze bez samych zmian.
# Opcja `--prune` usuwa zdalne gałęzie śledzące,
# które już nie istnieją na zdalnym serwerze.
git fetch --all --prune

# Aktywacja głównej gałęzi.
git switch main

# Ściągnięcie najnowszych zmian z głównej gałęzi zdalnej (origin/main)
# oraz ich automatyczny merge do lokalnej gałęzi main.
git pull origin mainBardzo częstym scenariuszem jest sytuacja, w której pracujemy od jakiegoś czasu na osobnej gałęzi i w międzyczasie gałąź główna, od której jakiś czas temu odbiliśmy została zaktualizowana. W tym momencie powinniśmy również zaktualizować naszą gałąź roboczą i najrozsądniej jest powtarzać tę czynność regularnie.
Aktualizacja gałęzi roboczej (merge)
Najprostszą metodą aktualizacji gałęzi roboczej jest merge, czyli dokładnie ten sam proces, który omawialiśmy przy okazji dorzucania zmian z PR do gałęzi głównej, tylko że tym razem działamy w drugą stronę (zmiany z main trafiają do <topic_branch>):
# Przełączenie się na gałąź roboczą.
git switch <topic_branch>

# Scalenie zmian z 'main'.
git merge mainJeśli okaże się, że zmiany w gałęzi <topic_branch> kolidują ze zmianami w gałęzi main (np. i tu i tu zmieniono tę samą linijkę kodu w tym samym pliku). W tej sytuacji auto-merge nie zadziała i Git przerwie proces scalania i poprosi nas o ręczne rozwiązanie konfliktu.
Git dodaje do plików z konfliktem specjalne znaczniki:
<<<<<<< HEAD
Zmiany z aktywnego brancha (<topic_branch>) -> current/ours
=======
Zmiany z gałęzi, którą merge’ujemy (main) -> incoming/theirs
>>>>>>> mainNaszym zadaniem jest ich usunięcie i wybranie odpowiedniej wersji, zanim będziemy mogli kontynuować proces merge’owania.
Aktualizacja gałęzi roboczej: (rebase)
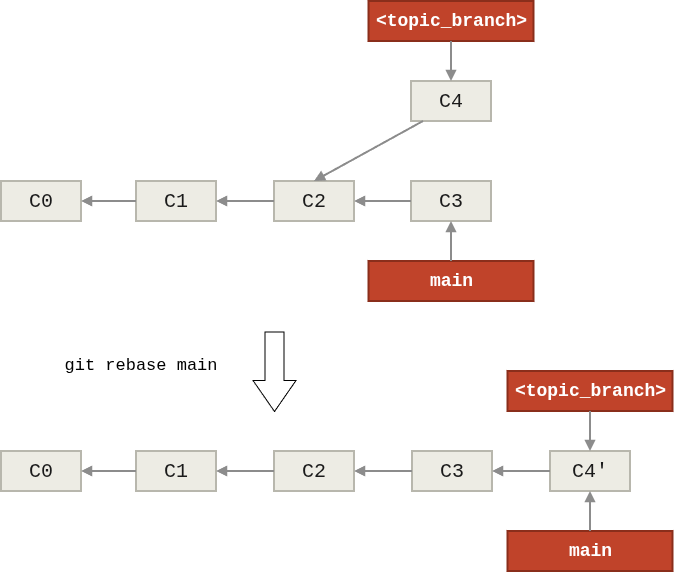
Trochę bardziej wyszukanym sposobem aktualizowania gałęzi roboczej jest rebase, czyli mówiąc krótko: zmiana bazy gałęzi roboczej. W odróżnieniu od zwykłego merge, historia commitów wygląda czyściej, bo jest liniowa (brak merge commits).
Wadą takiego podejścia jest fakt, że wszystkie commity z gałęzi roboczej są usuwane (tj. porzucane z historii gałęzi i z czasem usuwane z repozytorium przez mechanizm Garbage Collector) i tworzone są nowe commity z innymi skrótami SHA-1, przez co synchronizacja gałęzi zdalnej wymaga jej całkowitego nadpisania. Tak ten proces wygląda w skrócie:
- Git znajduje wspólnego przodka gałęzi, na której aktualne przebywamy (
<topic_branch>) oraz gałęzi, na której chcemy przeprowadzić operację rebase (main). - Identyfikowane są wszystkie różnice (diff) wprowadzone przez każdy commit gałęzi roboczej, których nie ma w gałęzi głównej, a następnie zapisane w plikach tymczasowych.
- Następuje przesunięcie (cofnięcie) wskaźnika gałęzi roboczej na ostatni commit gałęzi głównej.
- Wszystkie zmiany zapisane w punkcie 2. są kolejno dodawane w postaci nowych commitów, a wskaźnik gałęzi roboczej przesuwa się aż do commita z ostatnią zmianą.
Komendy wyglądają w ten sposób:
# Przełączenie się na gałąź roboczą.
git switch <topic_branch>

# Rebase z gałęzią główną.
git rebase main

# Wypchnięcie zmian do gałęzi zdalnej.
git push --force-with-lease origin <topic_branch>Ponieważ rebase przepisuje historię commitów gałęzi, musimy wymusić na Git nadpisanie repozytorium zdalnego, a konkretniej tę przepisaną gałąź zdalną. Służy do tego opcja --force, której lepiej unikać, ponieważ możemy przez nieuwagę wrzucić niechciane zmiany do zdalnej gałęzi, nadpisując przy okazji historię również dla innych użytkowników.
Lepiej jest stosować bezpieczniejszą opcję --force-with-lease, która spowoduje zablokowanie próby wypchnięcia zmian, jeśli na zdalnej gałęzi znajdują się commity dodane przez innych użytkowników.
Podobnie jak w przypadku procesu merge’owania tutaj również mogą wystąpić konflikty i Git poprosi nas o ich ręczne rozwiązanie. Jedyną różnicę jest to, że znaczniki przybierają trochę inną formę w przypadku rebase:
<<<<<<< HEAD
Zmiany z main -> current/ours
=======
Zmiany z aktualnie aplikowanego commita (z <topic_branch>) w ramach rebase -> incoming/theirs
>>>>>>> commit

